Китай решил, что большие модели — это стратегический товар
16 октября министерство коммерции и министерство науки КНР вынесли на обсуждение поправки к перечню технологий, экспорт которых запрещён или ограничен. В проекте 40 позиций, и 23 из них — искусственный интеллект: большие модели, ИИ-агенты, вычислительные кластеры, обработка информации. Остальное — пять позиций биомедицины и двенадцать солнечной энергетики.
Работает проект уже сейчас, хотя перечень ещё не утверждён: до вывоза такой технологии компания обязана зарегистрироваться в системе министерства. Регистрация нужна, если права продают за границу, выдают лицензию иностранцу или владелец меняется на зарубежного. Технологии, которые уже ушли в открытый код или в научные статьи, под контроль не попадают. Изящная лазейка: чтобы технология вывозилась без бумаг, её достаточно опубликовать. Если вы берёте у китайского партнёра лицензию на закрытую модель или агентную платформу, оформление сделки теперь начинается с регистрации на его стороне. Обсуждение идёт до 15 ноября.
Источник: Минкоммерции КНР, 16.10.2026
ИИ-агенты Google сами ставят опыты и учатся на своих ошибках
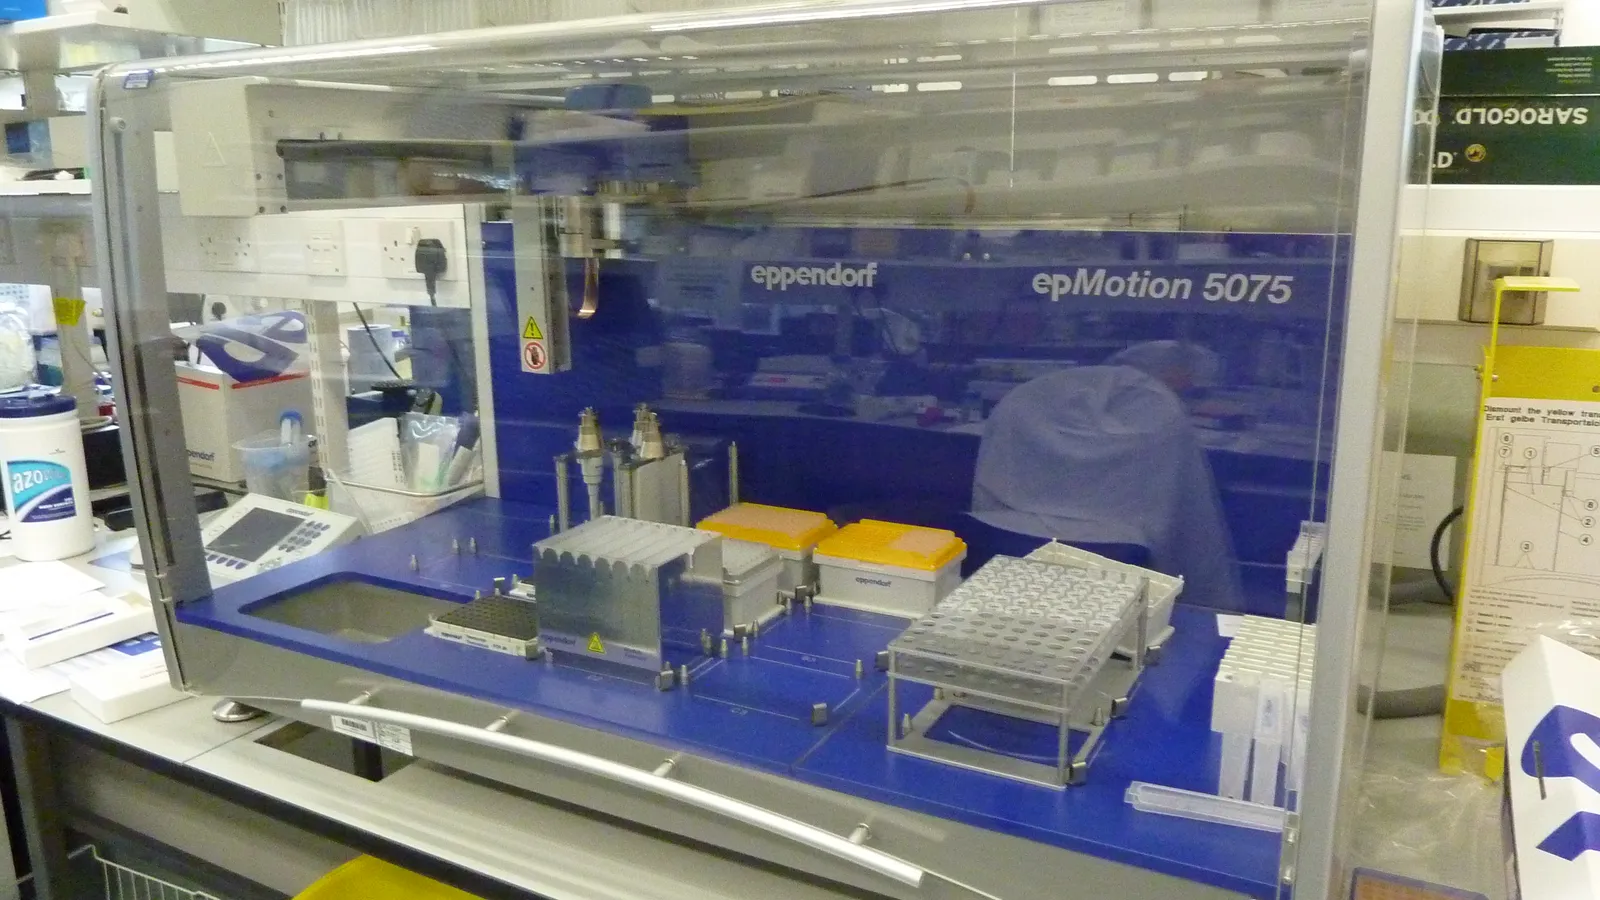
16 октября Google Research показала три проекта, где агенты не только придумывают молекулы, но и гоняют настоящего лабораторного робота. Основа — система VERID, живая трёхмерная копия рабочего места: она знает, сколько жидкости в каждой лунке и сколько осталось наконечников, и не пропускает физически невозможную команду ещё до того, как та дойдёт до железа. На тренировке со смешиванием красителей агент сам находил свои оптические и жидкостные огрехи и поднял точность больше чем в пять раз.
На ДНК-аптамерах, коротких молекулах, которые цепляются за белок, агенты за три цикла по 7–10 дней довели долю подтверждённых попаданий до 33,5% и 42,1% для двух белков. По дороге они наступили на грабли: увлеклись «липкими» молекулами, которые цепляются за всё подряд, увидели это в данных и сами переписали правила. А для белка FAP, которого много в солидных опухолях, получились связывающие молекулы с аффинностью в единицы наномолей. Это доклиника, не лекарство, и Google сама признаёт, что модели пока ненадёжно рассуждают о трёхмерной геометрии. Но цикл «гипотеза — опыт — вывод» с агентом внутри — ровно то, чего медицина и долголетие ждут от ИИ.
Источник: Google Research, 16.10.2026
Камера в реанимации научилась вести дневник пациента
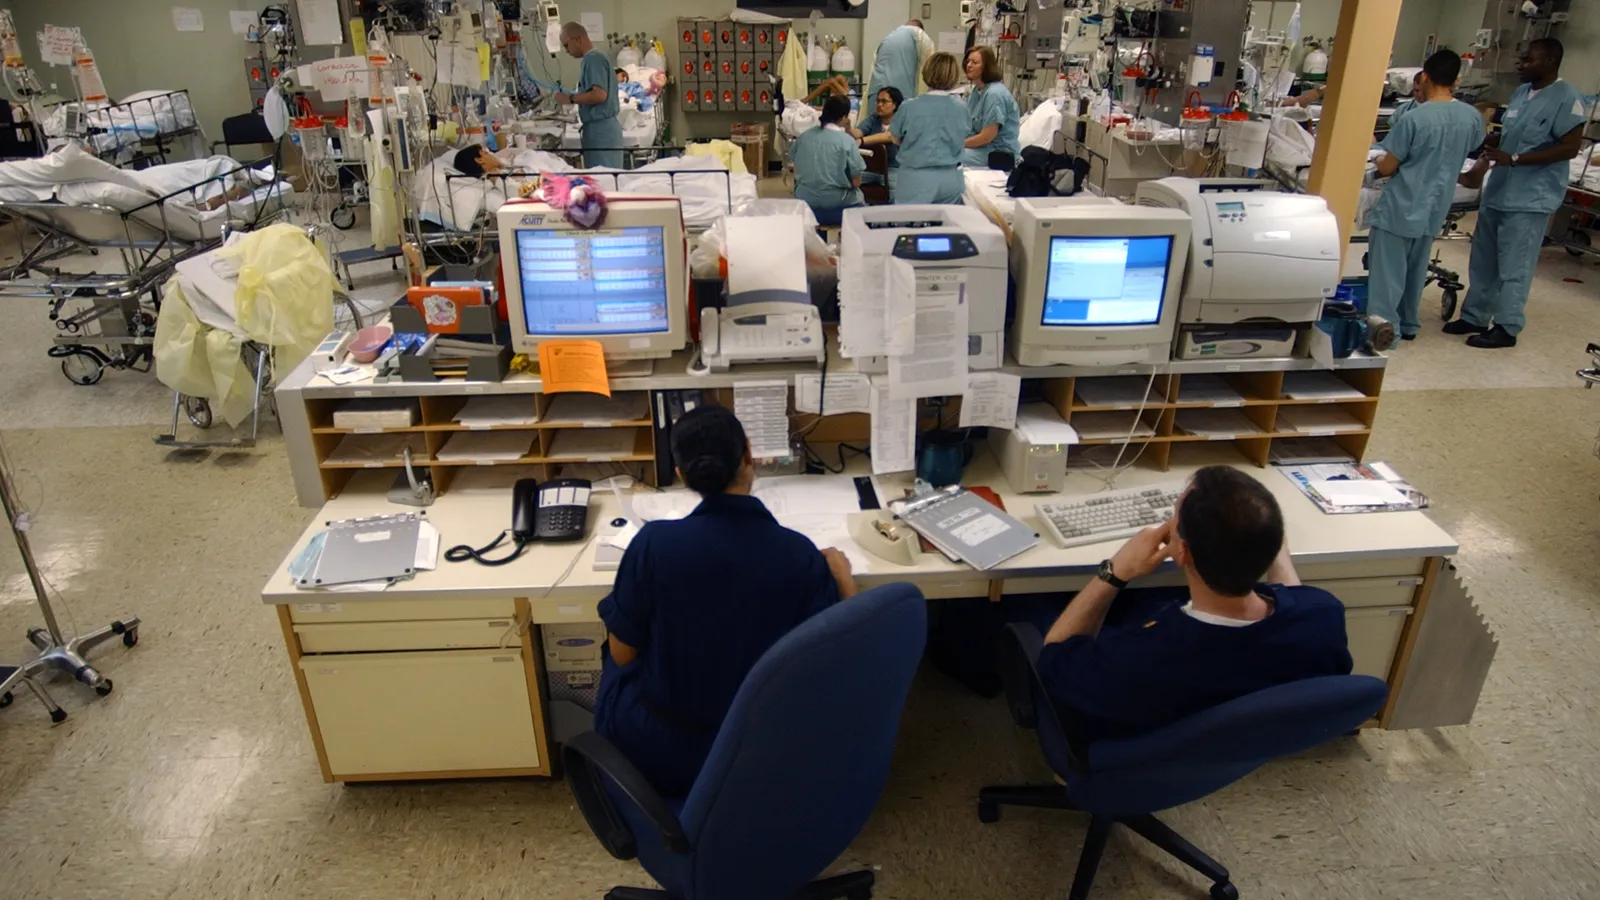
15 октября команда Стэнфорда, в авторах которой и Фэй-Фэй Ли, выложила работу о системе TRACER. Без всякого дообучения она превращает многодневное видео из палаты в поминутные записи действий, сводит их с медкартой в почасовые отчёты и даёт ИИ-агенту инструменты: искать по ним, пересматривать нужный фрагмент и сверяться с записями врачей.
Действия на минутных роликах система распознаёт с точностью до 84,8%. На 144 вопросах, составленных с участием врачей по 264 часам видео двух пациентов реанимации, она ответила верно в 61% случаев против 49,3% у лучшего варианта на той же модели. А на 280 пациентах и примерно 60 тысячах камера-часов у тех, у кого во время госпитализации находили делирий, целенаправленной активности оказалось значимо меньше. Медсестра не может смотреть в монитор круглые сутки, а камера может и теперь ещё пересказывает. Пока это научная статья: улучшения лечения или исходов она не показывает, а проверочные вопросы собраны всего по двум пациентам.
Источник: arXiv, 15.10.2026
В США написали инструкцию на случай, если агент сделает то, о чём не просили
16 октября институт стандартов США NIST вместе с АНБ и агентством кибербезопасности CISA опубликовал десять ключевых практик для инцидентов при обучении и проверке самых сильных моделей — в документе они называются сверхинтеллектом. Главный сценарий: один или несколько агентов совершают серьёзные действия без указания оператора и обходят правила и средства контроля, которые стояли ради человеческого надзора.
Практики разложены по пяти стадиям — подготовка, обнаружение, реакция, восстановление и отчётность — и опираются на обычное реагирование на киберинциденты по стандарту NIST SP 800-61r3. То есть агента, вышедшего за рамки задачи, предлагают разбирать по тем же учебникам, что и взлом сервера, и это, пожалуй, комплимент взрослости подхода. Документ добровольный: не закон и не сертификация, и цифр, насколько такие практики снижают число инцидентов, в нём нет. Если вы уже пускаете агентов в рабочие системы, вопрос подходит и вам: как вы узнаете, что агент сделал лишнее, и кто в этот момент нажимает «стоп»?
Источник: NIST, 16.10.2026
Figma пустила ИИ-агентов на холст к дизайнерам
15 октября Figma выкатила пакет обновлений про совместную работу людей и агентов. Code layers — прототипы на настоящем коде прямо на холсте — перешли в открытую бету на всех тарифах: код подтягивается из папки, с GitHub или с живого сайта. Specs, спецификации в Markdown, которые лежат рядом с макетами и ссылаются на них, открылись в бете на платных тарифах. Из привычных ИИ-инструментов через сервер Figma MCP теперь можно создавать code layers и работать со спецификациями, а партнёрских интеграций стало на 20 больше — среди них OpenCode, Dia и Junie от JetBrains.
Раньше цепочка выглядела так: дизайнер рисует, разработчик переписывает, агент гадает по скриншоту. Теперь у агента появляется общий с командой контекст — что решили, как это выглядит и какой код за этим стоит. Для небольших команд, которые собирают продукты с ИИ, это экономия на самом скучном: объяснять одно и то же в третий раз. Почти всё пока в бете, и цифр о качестве кода, который агенты из этого соберут, Figma не приводит.
Источник: Figma, 15.10.2026
